 フレアはゆる
・社内の資料をAIで検索できるようにしたい
・似た商品や記事のおすすめを作りたい
・AI Searchと自作のどちらにするか迷っている
Cloudflare Vectorize は、Cloudflare Workers から使うベクトルデータベース(数値の並びを保存し、近いものを探すデータベース)です。文章や画像を AI モデルで数値の並び(埋め込み)にして入れておくと、言葉が一致しなくても意味の近いものを探せます。社内文書の検索や RAG に使え、Workers の無料プランでも利用できます。
この記事では、仕組み、できること、「次元の数」で決まる料金、AI Search との使い分け、始め方と注意点を整理します。内容は2026年11月時点の Vectorize の公式ドキュメントに沿っています。
この記事のゴール(読了目安 約8分)
Vectorizeの仕組みと料金の数え方を理解し、自分で組むかAI Searchに任せるか判断できるようになる
Vectorizeとは?意味で探すベクトルDB
Vectorize は、Workers から使う、世界に分散したベクトルデータベースです。一般提供(GA)されていて、Workers の無料・有料のどちらのプランでも使えます。
扱うのは埋め込み(エンベディング)で、文章・画像・音声などを数値の並びに表したものです。モデルが「似ている」と見なした入力どうしは、ベクトル(数値の並び)の距離が近くなります。
- 保存するもの:埋め込み(元の文章や画像は保存しない)
- 探し方:問い合わせたベクトルに近い順
- 使う場所:Workers のコード、Wrangler、REST API
埋め込みは Workers AI のモデルで作っても、OpenAI など外部で作って持ち込んでもかまいません。Vectorize では、データベース1つを「インデックス」と呼びます。
問い合わせのたびにデータ全体を AI に渡さずに済むのが、ベクトルデータベースの利点です。 AI モデルには入力の大きさに上限があるためです。
仕組み:埋め込みを近さで探す
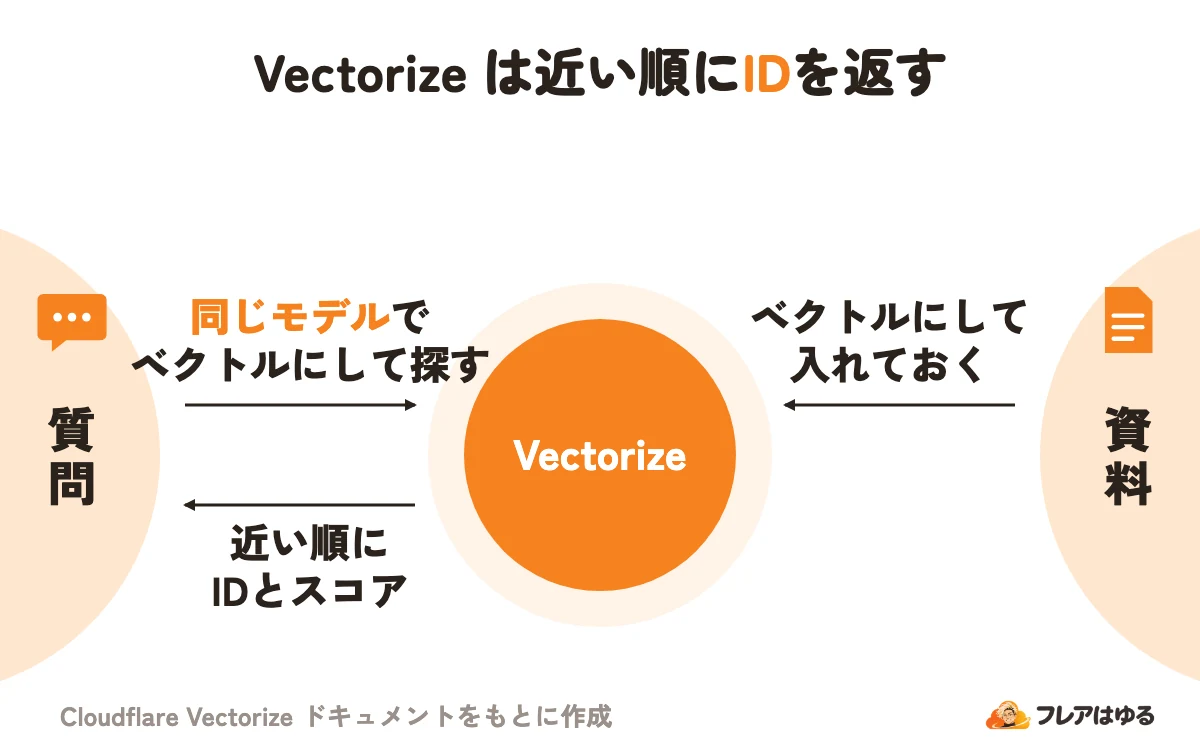
入れるときも探すときも、同じモデルでベクトルにするのが要です。流れは次の4段です。
- 手元の文書や画像を埋め込みモデルでベクトルにし、インデックスに入れる
- 検索の言葉も同じモデルでベクトルにする
- 問い合わせると、近い順に ID とスコア(近さを表す数値)が返る。既定は5件
- 返った ID を手がかりに、元のデータを取り出す
元のデータは R2・Workers KV・D1 などに置き、ベクトルのメタデータ(付帯情報)に ID や置き場所を入れておきます。
元の文章や商品データを表の形で持つなら D1 が向いています。D1 の料金と使い分けは Cloudflare D1とはで解説しています。キーで引くだけの小さな文書なら Workers KV に置く方法もあります。
インデックスを作るときは、次元数(ベクトルの数値の個数)と距離の測り方を決めます。どちらも作った後には変えられません。 次元数はモデルの出力に合わせます。
距離の測り方は cosine・euclidean・dot-product の3つです。公式は、文章の検索には cosine、画像や音声の認識には euclidean が向くことがあるとしています。
できること:意味検索・推薦・RAG
公式が挙げる使い道は次の4つで、RAG にも使えます。
インデックスにすでにあるベクトルを起点に、似たものを探す queryById() もあります。
RAG(検索拡張生成。検索で見つけた資料を添えて AI に答えさせる方法)では、資料を埋め込みにして先に入れておき、質問が来たら次の順に進みます。
- 質問を同じモデルで埋め込みにする
- その埋め込みで Vectorize を検索する
- 返ったベクトルから元の内容を引く(メタデータにあれば省ける)
- 内容を質問に添えて LLM(大規模言語モデル)に渡す
AI モデルを呼ぶのは1と4です。その呼び出しを見える化・制御したいときは、Cloudflare AI Gatewayとはを参考にしてください。
検索の範囲は、メタデータ(顧客 ID や商品カテゴリーなど)と名前空間(インデックスの中を顧客や店舗ごとに区切る仕組み)で絞れます。絞り込みが先に行われ、絞った中から近い順に選ばれます。
料金と無料枠:次元の数で数える
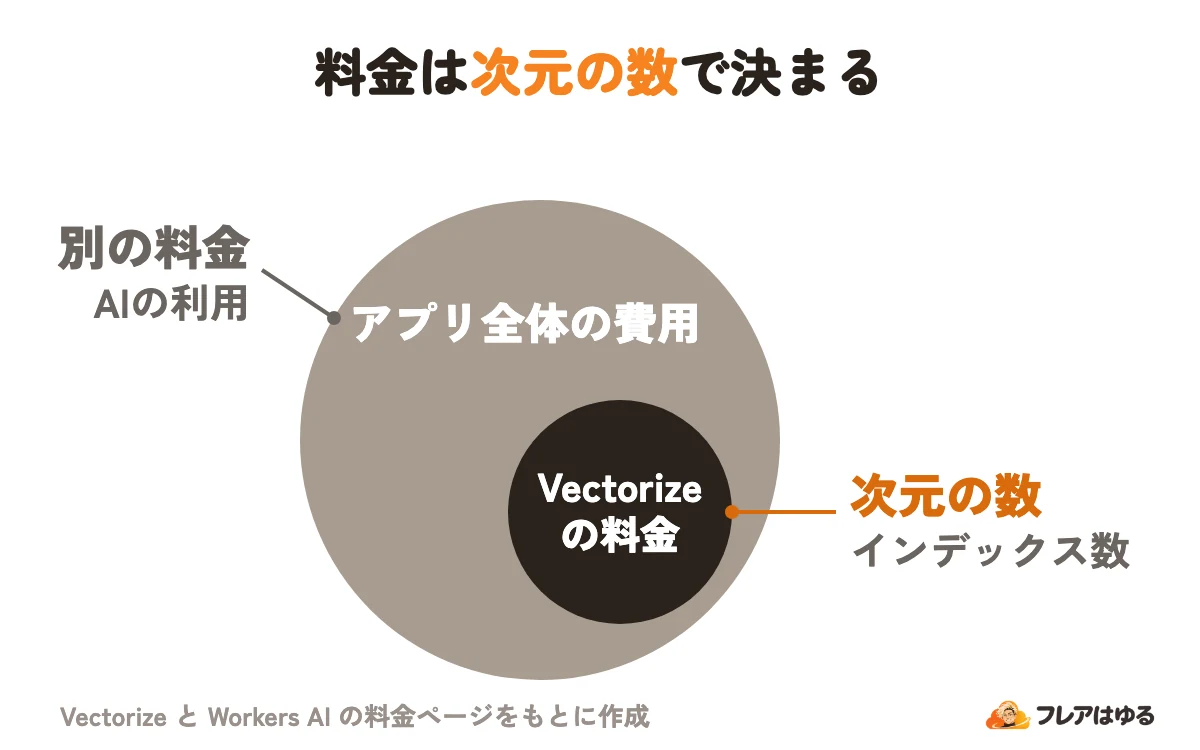
2026年11月時点の公式ページでは、請求の元は「問い合わせた次元」「保存した次元」「インデックスの数」の3つです。変わることがあるので、Vectorize の料金ページで確かめてください。
有料プランは Workers の有料プラン(月5ドルから)です。数え方は次のとおりです。
- 問い合わせた次元=(問い合わせの回数+保存しているベクトルの数)×次元数
- 保存した次元=保存しているベクトルの数×次元数
問い合わせた次元には、回数だけでなく保存件数も入ります。 公式の例では、384次元を1万件入れて100回問い合わせると約388万です。
公式の数え方で計算すると、無料プランの保存枠(500万)に入るのは768次元で約6,500件です。公式の例のうち「384次元・5,000件・月1万回」は無料プランに収まり、「768次元・1万件・月3万回」は無料プランの枠を超えます。
CPU・メモリ・稼働時間・エグレス(外へ送り出す通信)には課金されません。Wrangler や HTTP API からの問い合わせも利用量に数え、空のインデックスもインデックスの数に入ります。埋め込みを作る費用は別で、Workers AI なら1日1万 Neurons(利用量の単位)まで無料です。Neurons の数え方は、Workers AI と Agents SDK の記事で解説しています。
AI Searchとの違いと使い分け
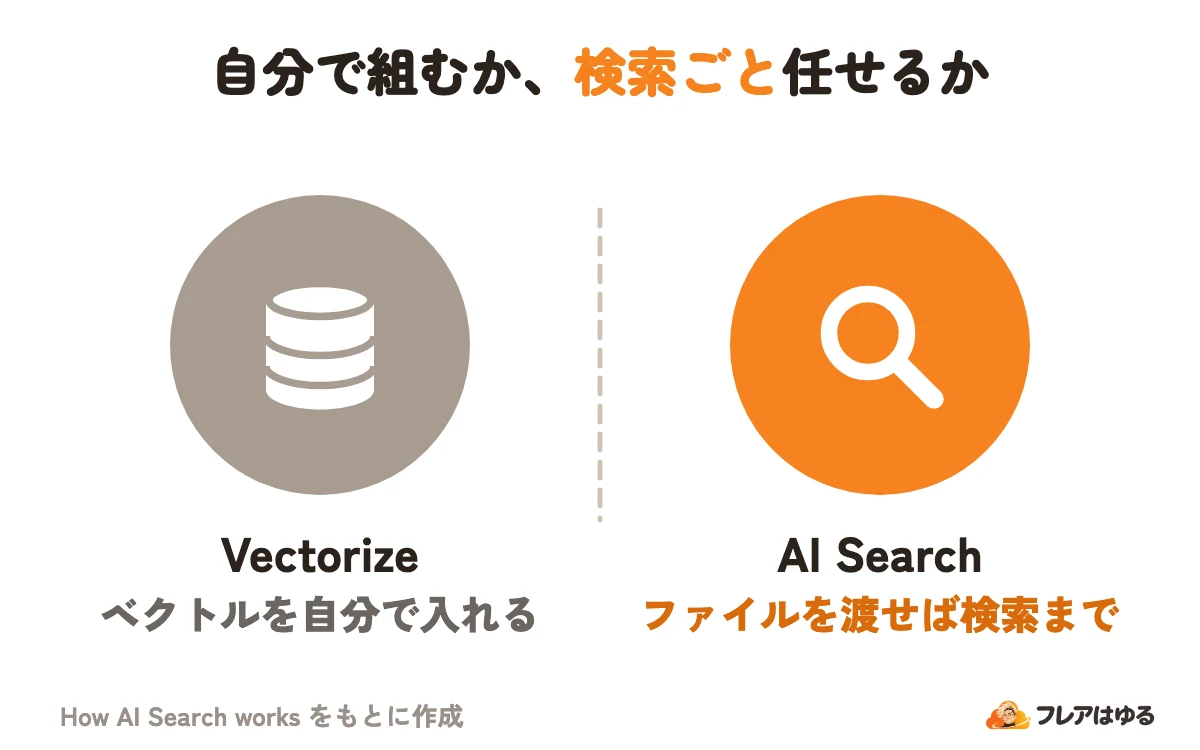
AI Search は Vectorize の上に作られ、検索に要るほかの部分をまとめて提供する仕組みです。公式は、ベクトルを自分で管理するなら Vectorize、検索を任せるなら AI Search と使い分けを示しています。
AI Search にも、R2 と Vectorize で動く保存先と索引が最初から付いています。編集部では、部品を自分で組むか、組み上がったものを使うかの違いと捉えています。埋め込みモデルや検索の流れを自分で決めたいなら Vectorize、手持ちのファイルに検索や RAG を早く付けたいなら AI Search が向きます。
AI Search の仕組みや料金は Cloudflare AI Searchとはで解説しています。
始め方:インデックス作成から検索まで
公式の Get started に沿った流れです。Cloudflare のアカウントと Node.js・npm を用意し、Wrangler(Workers のコマンドラインツール)は 3.71.0 以降を使います。
- Worker のプロジェクトを作る
- モデルの次元数に合わせてインデックスを作る
- wrangler.jsonc にバインディング(コードから機能を使う接続設定)を書く
- 絞り込むなら、ベクトルを入れる前にメタデータの索引を作る
- コードで埋め込みを作り、upsert で入れ、query で探す
- ログインして公開する
npm create cloudflare@latest -- vectorize-tutorial
npx wrangler vectorize create embeddings-index --dimensions=768 --metric=cosine
npx wrangler vectorize create-metadata-index embeddings-index --property-name=url --type=string
npx wrangler login
npx wrangler deploy
{
"vectorize": [{ "binding": "VECTORIZE", "index_name": "embeddings-index" }],
"ai": { "binding": "AI" }
}例は bge-base-en-v1.5 に合わせた768次元・cosine です。ai の行は Workers AI で埋め込みを作るときに足します。query に渡すのはベクトルの部分(.data[0])だけです。 Workers AI の応答をそのまま渡すとエラーになります。書き込みの反映は npx wrangler vectorize info で確かめられます。
使う前の注意点
本番の前に、次の点を確かめます。
- 次元数と距離の測り方は変えられないので、埋め込みモデルを先に決めます
- 書き込みは非同期で、検索に出るまでふつう数秒かかります(結果整合)
- まとめて入れます。公式の例では、25万件を1件ずつ入れると1時間以上かかりうる一方、2,500件ずつなら数分で検索に出ます
- insert は同じ ID を上書きしません。更新は upsert で、値とメタデータが丸ごと置き換わります
- メタデータの索引は10個までで、作る前に入れたベクトルは入れ直しが要ります。文字列は先頭64バイトで絞り込みます
よくある質問
日本語の文章も検索できますか?
埋め込みモデルしだいです。Get started の bge-base-en-v1.5 は英語向けですが、Workers AI には日本語用の plamo-embedding-1b や多言語の bge-m3 もあります。インデックスの次元数はモデルの出力に合わせ、1ベクトルは1536次元までなので、モデルを決めてからインデックスを作ります。
OpenAIの埋め込みも使えますか?
使えます。外部で作った埋め込みも持ち込めます。次元数はモデルに合わせ、公式の例では OpenAI の ada-002 が1536次元で上限ちょうどです。
手元の開発環境で試せますか?
Vectorize には手元で動く模擬がありません。開発中はバインディングに remote: true を付けて本物のインデックスにつなぎ、本番のデータを守るなら開発用のインデックスを別に指定します。
AI Search経由でもVectorizeの料金はかかる?
AI Search が代わりに使う Vectorize の分は、Vectorize の請求には出ず、AI Search の料金で数えます。料金の中身は AI Search の記事で確かめてください。
古いVectorize(V1)のインデックスは使えますか?
V1 は2024年8月に非推奨になり、12月から新しく作れなくなりました。既存の V1 への操作は動きますが、本番では勧められず、自動の移行もまだ提供されていません。Wrangler 3.71.0 より前で作ったものは V1 の可能性があります。
この記事のポイント
- VectorizeはWorkersから使うベクトルDBで、埋め込みを保存する
- 料金は問い合わせた次元・保存した次元・インデックス数で決まる
- 次元数と距離の測り方は後で変えられず、モデルを先に決める
- 検索やRAGをすぐ付けたいなら、上に作られたAI Searchも選べる
まとめ
Cloudflare Vectorize は、埋め込みを保存して「意味の近さ」で探すための部品です。元のデータは D1・Workers KV・R2 に置いて ID でつなぎます。料金は次元の数で数え、問い合わせた次元には保存件数も入ります。
次の一歩は、埋め込みモデルを決め、その次元数と距離の測り方でインデックスを作ることです。無料プランで小さく試してから本番に広げてください。検索ごと任せたいなら、AI Search も選択肢です。