 フレアはゆる
・Workersで使えるSQLのDBを探している
・無料枠を超えたら何が起きるか知りたい
・KVやHyperdriveとの選び方に迷っている
Cloudflare D1 は、サーバーを用意せずに使える、Cloudflare 運用の SQL データベースです。SQLite の SQL で読み書きし、Worker や Pages Functions からはバインディングで、外部からは HTTP API で呼び出します。クエリを流さなければ計算の料金は発生せず、無料プランから始められます。
この記事では、D1 がクエリをさばく仕組み、料金の数え方、無料・有料の上限と超えたときの動き、ほかの保存先との使い分け、始め方を扱います。どれも2026年11月時点の公式ページで確かめた内容です。Worker の仕組みそのものは、Workers の記事に任せます。
この記事のゴール(読了目安 約8分)
読んだ行で決まる料金と10GBの上限を知り、D1とほかの保存先を選び分けられるようになる
Cloudflare D1とは
D1 は、SQLite(ファイル1つで動く軽量なデータベース)の SQL の決まりに沿って動く、サーバーレスのデータベースです。中で SQLite のクエリエンジンを使うので、SQLite の SQL の大半がそのまま通り、全文検索の FTS5 と JSON の拡張も使えます。
呼び出し方は2通りあります。
- Worker・Pages Functions から:バインディング(Worker から D1 などを呼ぶつなぎの設定)を通し、
env.<バインディング名>で呼ぶ - Worker の外から:HTTP API で呼べ、外部のツールでも扱える
Worker の動き方や無料枠は、Cloudflare Workersとはで扱っています。
サーバーを持たずに、Worker から SQL で表のデータを読み書きできるのが D1 です。 2024年4月1日に一般提供(GA)となり、無料と有料のどちらのプランでも使えます。押さえておきたい点は次の3つです。
- Time Travel:バックアップを取らなくても、過去の任意の分に戻せる(期間は上限の章で)
- 読み取りレプリカ(ベータ版):読み取り専用の写しを各地域に置ける(次の章で)
- ORM(コードの書き方で DB を扱う道具):製品ページは Prisma と Drizzle を挙げる
D1が1つずつ処理する仕組み
1つの D1 データベースでは、既定で世界の1か所にある主データベース(書き込みを受け付ける元のデータベース)がクエリを受け、1つずつ順に処理します。速さも、さばける量も、この性質で決まります。
主データベースは、作成を頼んだ場所の近くに作られます。作成時の位置ヒント(地域の希望。アジア太平洋は apac)で地域を伝えられますが、その地域で動く保証はありません。
上限ページの目安では、クエリの平均が1ミリ秒なら1秒に最大1,000、100ミリ秒なら最大10です。クエリ1本が短いほど、1秒にさばける数は増えます。 要求が集まりすぎると待たせ、待ち行列があふれると overloaded のエラーになります。batch() で文をまとめて送れば、要求の回数も減らせます。
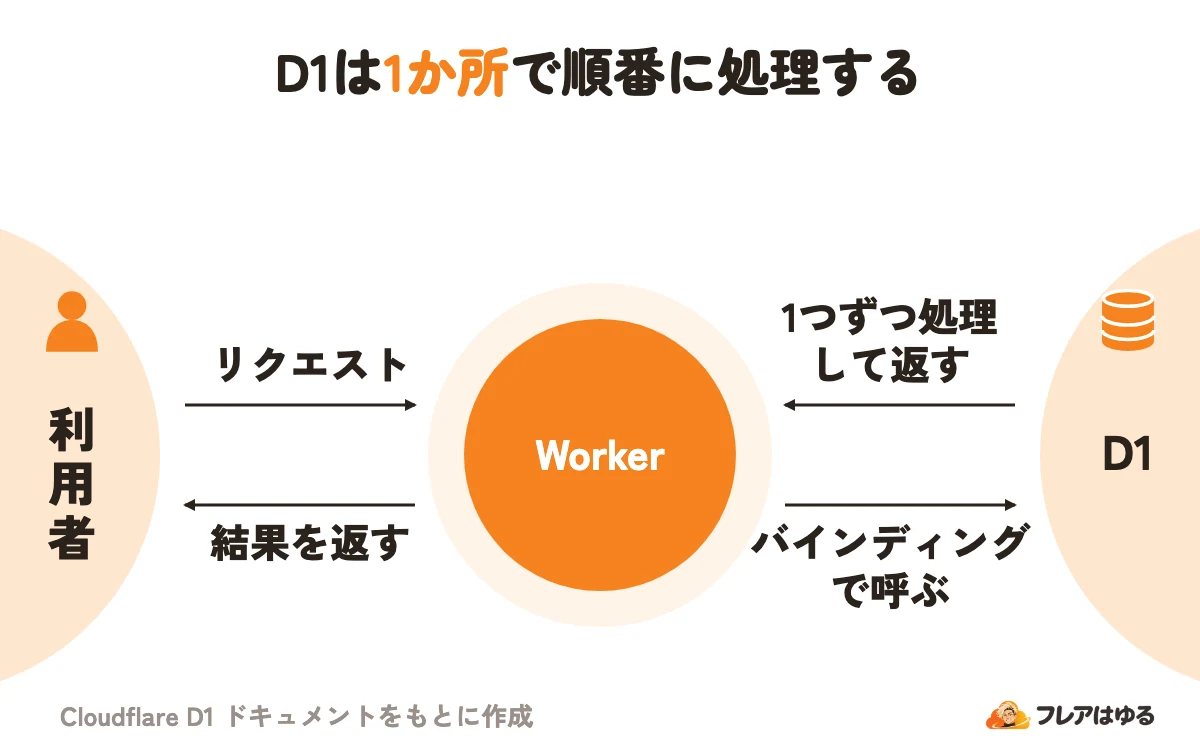
D1 のデータベース1つ1つは、裏側で1つの Durable Object に支えられています。その仕組みはDurable Objectsとはで説明しています。
読み取りを近くで受けたいときは、ベータ版の読み取りレプリカ(読み取り専用の写し)を使います。ダッシュボードの Settings で有効にすると対応する各地域に写しが自動で作られ、書き込みは主データベースへ送られます。写しを使うには Sessions API(withSession())が要ります。写しの分の追加料金はありません。
D1の料金と無料枠の数え方
2026年11月時点の公式の料金ページでは、D1 の請求は読んだ行・書いた行・保存量・データベースの数で決まります。
有料プランは、Workers の有料プラン(最低月5ドル)を指します。D1 を呼ぶ Worker の処理は Workers の料金で別に数え、エグレス(外へ送り出す通信)は無料です。
数え方の注意は3つです。
- 読んだ行は、返した行でなく読んだ(スキャンした)行の数。5,000行の表を
SELECT *で全件読めば5,000行 - インデックス(検索用の索引)の無い列で絞ると、返す行より多く読む。付けるとその列を書くたびに書いた行を1行多く数えるが、ほとんどは読む行の減りが上回る
- 行が 1KB でも 100KB でも1行と数える。Wrangler(Cloudflare 公式のコマンドラインツール)やダッシュボードから流したクエリも対象
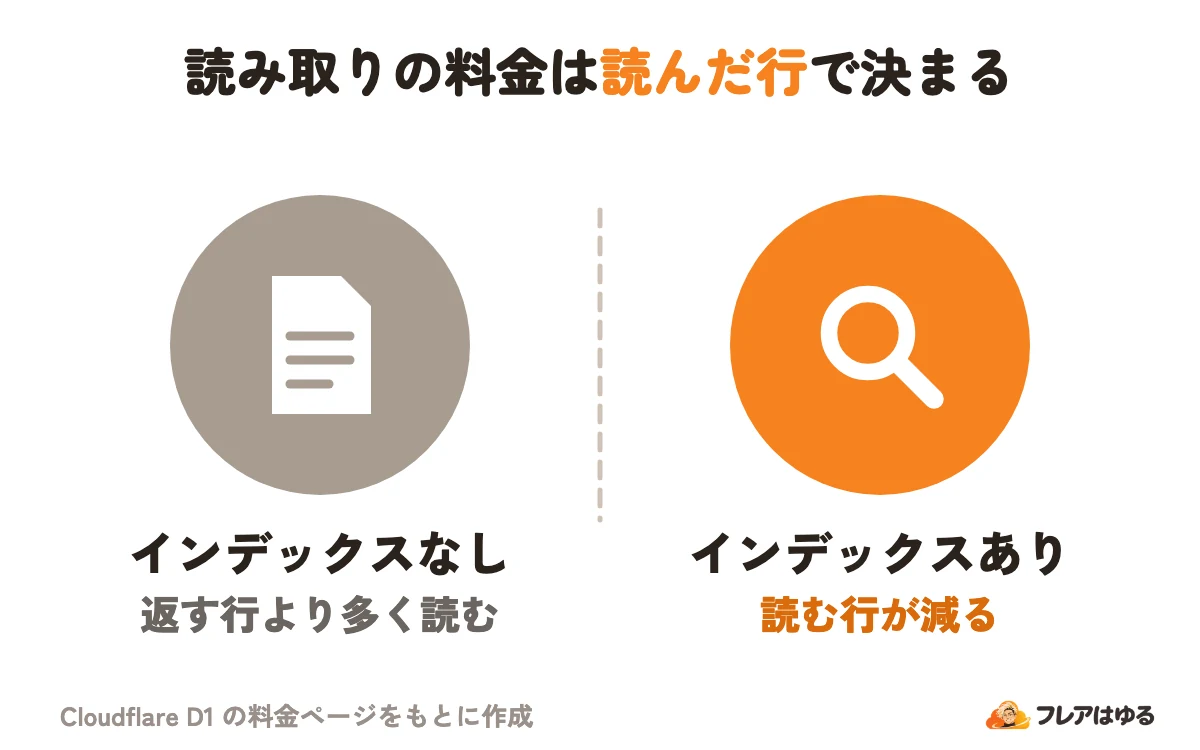
思いがけない請求の多くは、返す行よりずっと多くの行を読む、よく流れるクエリから生まれます。 行数は、クエリの結果の meta(rows_read・rows_written)で確かめられます。
無料・有料の上限と超えたとき
無料プランは1日の行数と保存量に上限があり、超えると止まります。有料プランでも、1つのデータベースは 10GB で頭打ちです。2026年11月時点の公式の上限ページから、設計に関わる値を抜き出しました。
無料プランで1日の読んだ行・書いた行の上限に達すると、UTC の0時(日本時間9時)のリセットまで、Worker からも REST API からもクエリがエラーになります。保存したデータは消えず、上限に達するとメールで知らせが届きます。
保存量の上限は扱いが別で、使わないデータベースや古いデータを消すまで、データの追加や表の作成・変更ができなくなります。どちらも、有料プランに切り替えれば通常数分で外れます。
10GB の壁は、有料プランでも動かせません。そもそも D1 は、小さなデータベースを利用者ごとやテナント(契約先)ごとに用意し、その数で規模を広げる作りです。10GB に収まらないデータは、最初から複数のデータベースに分けて持つ前提で設計します。
KVやDurable Objectsとの使い分け
SQL で条件を変えながら探したり集計したりする表のデータは、D1 に置きます。性質の違うデータについては、公式の「保存先の選び方」がほかの保存先を勧めています。
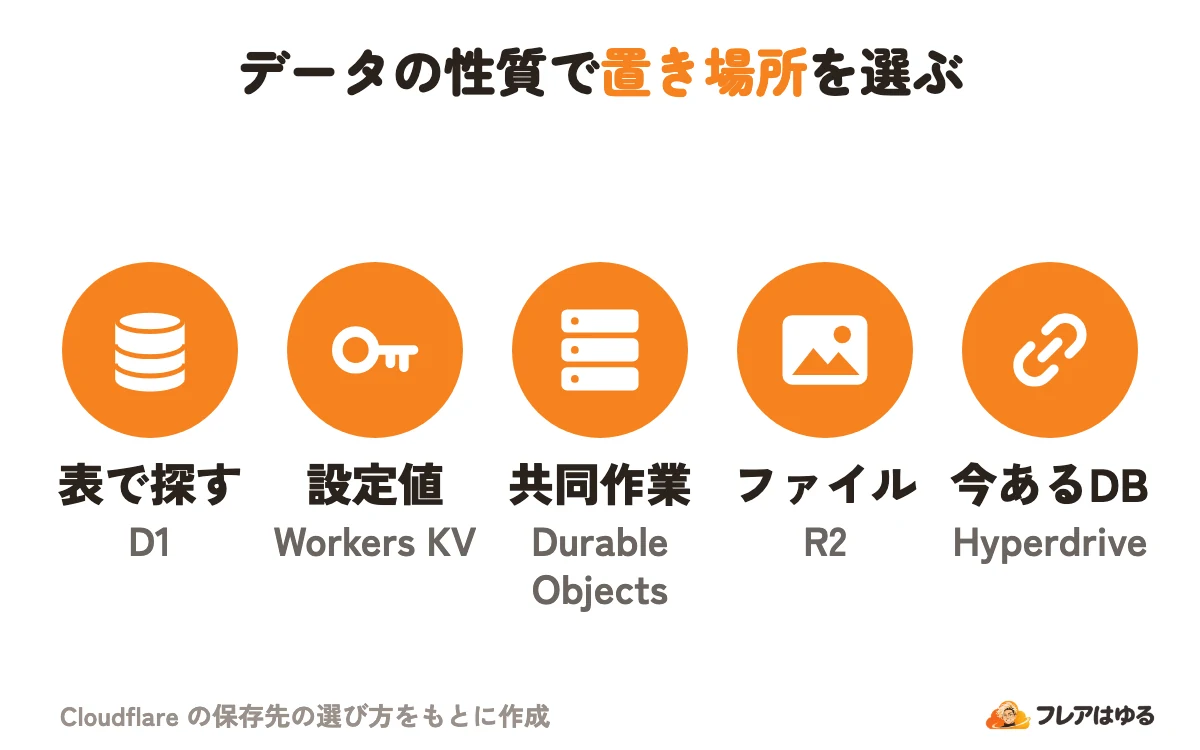
設定値やセッションのように何度も読まれる値は、KV が受け持ちます。その仕組みはWorkers KVとはの記事にまとめています。
MySQL や PostgreSQL のデータは、型と SQL の書き方が直接は合わないため、D1 に取り込めません。 AWS や Google Cloud、Supabase などにあるデータベースを、今のドライバーや ORM のまま Workers から使う方法は、Cloudflare Hyperdriveとはで紹介しています。
D1の始め方:作成からデプロイまで
ここでは公式の Get started の流れを、Wrangler で Worker から D1 を読むところまでたどります。ダッシュボードの D1 SQL database のページからも作れ、Console で SQL を流せます。
- ひな形から Worker を作る。Hello World example と Worker only を選び、最後の公開の問いは No
- データベースを作る。「Would you like Wrangler to add it on your behalf?」に Yes と答えると、設定ファイルにバインディングが書き足される
- 表を作る SQL を
schema.sqlに書き、--localを付けて手元の D1 で実行する - Worker で
env.<バインディング名>のprepare()に SQL を渡し、bind()で値を入れてrun()で実行する。bind()を使えば SQL インジェクション(任意の SQL を流される攻撃)を防げる --remoteで同じ SQL を Cloudflare 上のデータベースに流し、公開する
npm create cloudflare@latest -- d1-tutorial
cd d1-tutorial
npx wrangler@latest d1 create prod-d1-tutorial
npx wrangler d1 execute prod-d1-tutorial --local --file=./schema.sql
npx wrangler d1 execute prod-d1-tutorial --remote --file=./schema.sql
npx wrangler deploy
--local の SQL は手元の D1 にしか届かないので、公開する前に --remote でも同じ SQL を流します。 手元で動きを見るなら npx wrangler dev を使います。
よくある質問
手元のSQLiteのデータを移せますか?
SQLite 3.0 以上のデータなら移せます。.sqlite3 のファイルは直接入らないので、.dump で SQL ファイルに変え、BEGIN TRANSACTION と COMMIT; を消してから --remote 付きの wrangler d1 execute で流します。
消したデータベースを元に戻せますか?
データベースごと消したときは、7日以内に undelete API で復元を頼みます。中身を誤って変えたときは、Time Travel で無料7日・有料30日以内の任意の分に戻せます。Time Travel の復元は、今のデータをその場で上書きします。
保存したデータは暗号化されますか?
保存したものはすべて AES-256 で暗号化され、設定は要りません。鍵は Cloudflare が管理します。Worker との通信や、Wrangler・HTTP API での操作も TLS で守られます。
PrismaやDrizzleは使えますか?
製品ページは Prisma と Drizzle を挙げています。D1 のドキュメントには Prisma のチュートリアルもあります。公式の一覧に載るツールは、D1 のチームではなく各作者が保守しています。
Pages Functionsからも使えますか?
使えます。D1 は Workers と Pages のプロジェクトから使うデータベースで、Pages Functions にもバインディングでつなげます。
この記事のポイント
- D1はWorkersからバインディングで呼ぶ、SQLiteのSQLのDB
- 料金は返した行でなく読んだ行で数え、インデックスで減らせる
- 無料の1日の上限を超えると、UTCの0時までクエリがエラーになる
- 1つのDBは10GBまで。今あるMySQL等はHyperdriveへ
まとめ
D1 は、Worker から SQLite の SQL で読み書きする、サーバー不要のデータベースです。データベース1つは1か所でクエリを順に処理し、請求は読んだ行と書いた行、保存量で決まります。無料プランは1日の上限に達するとリセットまで止まり、有料でも1つ 10GB が上限です。
最初は手元(--local)で表を作って動かし、meta の rows_read を確かめながらインデックスを足していきます。設定値は Workers KV、今ある MySQL・PostgreSQL は Hyperdrive と、データの性質で置き場所を分けます。