 フレアはゆる
・アクセスログやイベントを集計したい
・旧名のPipelinesやR2 SQLを使っていた
・D1やK2との使い分けを知りたい
Cloudflare Basin は、R2 に置いた Apache Iceberg の表にデータを取り込み、SQL で調べるサーバーレスの分析基盤です。取り込み・表の管理・SQL の3製品でできていて、クエリ用のクラスターを持たずにログやイベントを集計できます。2026年10月の一般提供と同時に、旧名の Cloudflare Pipelines・R2 Data Catalog・R2 SQL は Basin の製品名に変わりました。
この記事では、3製品の仕組み、料金の数え方、D1・K2 との違い、始め方と注意点を、Basin の公式ドキュメント に沿って扱います。
この記事のゴール(読了目安 約8分)
Basinの3つの製品と料金の数え方を知り、自分の分析に使うか判断できるようになる
Basinとは:R2で動く分析データの基盤
Basin は、データを受け取ってから R2(Cloudflare のオブジェクトストレージ)に表として置き、SQL で集計するまでを1つにまとめた基盤です。保存の形式は Apache Iceberg(R2 などのファイルを表のように扱うオープンな形式)です。R2 の仕組みと料金は、Cloudflare R2 の記事で解説しています。
名前は一般提供と同時に変わりました。旧名との対応は次のとおりです。
旧名で作った資源と設定はそのまま動き、時間をかけて廃止されます。公式が挙げる特徴は次のとおりです。
- ストリーミングの基盤やクエリのクラスターを管理しなくてよい
- オープンな Iceberg なので、ほかのツールへ持ち出せる
- 表の保守を自動で行える
- R2 の表を読むときにエグレス(外への転送)の料金がかからない
3製品はまとめて使っても、必要なものだけ選んでもかまいません。
仕組み:取り込む・表を管理する・調べる
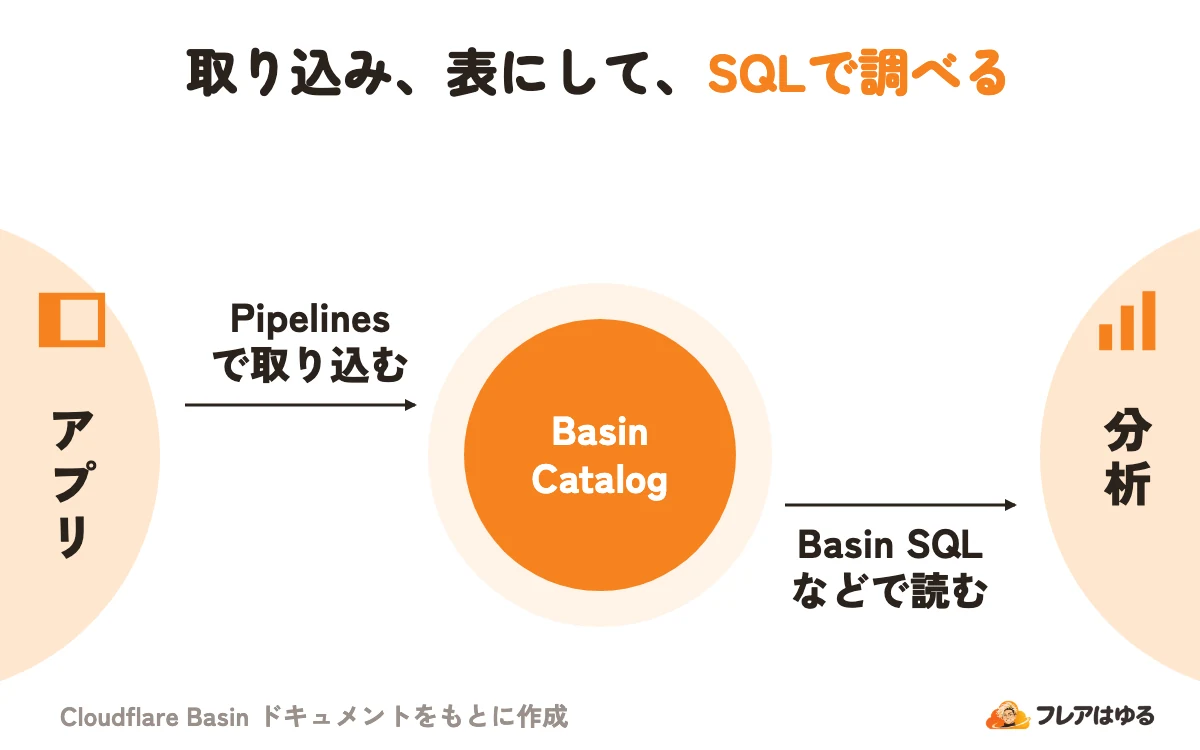
データは、Pipelines が取り込み、Catalog が R2 の表として管理し、Basin SQL などで調べる順に流れます。
Basin Pipelines:受け取って整える
Pipelines は3つの部品でできています。
- ストリーム:HTTP か Worker のバインディング(Worker から資源を使う設定)でイベントを受ける入り口
- パイプライン:ストリームとシンクを SQL の変換でつなぐ
- シンク:書き出し先。Iceberg の表か、R2 の Parquet・JSON ファイル
書き出しは exactly-once(重複も欠落もない)です。次のパイプラインの SQL は、条件に合うイベントだけを書く例です。
INSERT INTO my_sink SELECT * FROM my_stream WHERE event_type = 'purchase' AND amount > 100Basin Catalog:R2の表の目録
R2 のバケットに組み込まれた Iceberg のカタログで、表の一覧と最新のファイルの場所を1か所で持ちます。有効にすると、外部のツールがつなぐための Catalog URI とウェアハウス名が出ます。小さなファイルをまとめるコンパクションなど、表の保守も任せられます。
Basin SQL:読み取り専用の集計エンジン
Catalog の表を調べるサーバーレスのクエリエンジンです。Wrangler か HTTP API でクエリを送り、JOIN やウィンドウ関数も使えますが、書き込みはできません。表は標準の Iceberg なので、DuckDB・Spark・Trino などからも同じ表を読めます。
できること:ログやイベントの集計
公式が挙げる用途は、サーバーのログ、アプリのイベント、IoT の計測値、クリックの記録などの集計です。製品ページの例は次の4つです。
- ログの分析:大量のログやイベントを SQL で調べる
- BI:クリック・イベント・取引を集めて分析する
- ETL:保存の前に SQL で絞り込みや整形をする
- 複数のクラウドでの分析:R2 に置いた表を、ほかのクラウドや手元のツールから読む
公式ブログには、エラーのログだけを残し、IP アドレスをハッシュにしてから保存する例があります。
Cloudflare のログは、Logpush で Pipelines へ直接送れます。 ゾーンの HTTP リクエスト・ファイアウォール・DNS のログと、アカウントの Workers のトレースが対象で、ストリームなどは自動で作られます。Workers のログの見方は Workers Observability の解説 にまとめています。
料金と無料分:3つの製品で数える
料金は3製品それぞれで数え、無料分は月ごとです。R2 の保存と操作の料金は、Basin とは別にかかります。
2026年11月時点の公式ページの料金は次のとおりです。
書き出しの無料分はシンク共通で、単価は JSON が 0.03ドル、Parquet・Iceberg が 0.06ドルです。R2 の主な料金も並べます。
数え方の注意は次の3つです。
- シンクは圧縮前、SQL は圧縮後のデータ量で数える
- コンパクションは、有効にした表だけ別に料金がかかる
- SQL は1クエリ最低10MB。失敗したクエリは無料で、R2 を読んだ分は Class B 操作にも数える
公式の試算では、500GB を取り込み 300GB を表に書く例で、Basin の分は月33.15ドル(R2 を除く)です。請求は Enterprise 以外のアカウントで2026年8月3日から始まっています。細かい条件は Basin の料金ページ で確認してください。
D1・Queues・K2との違い
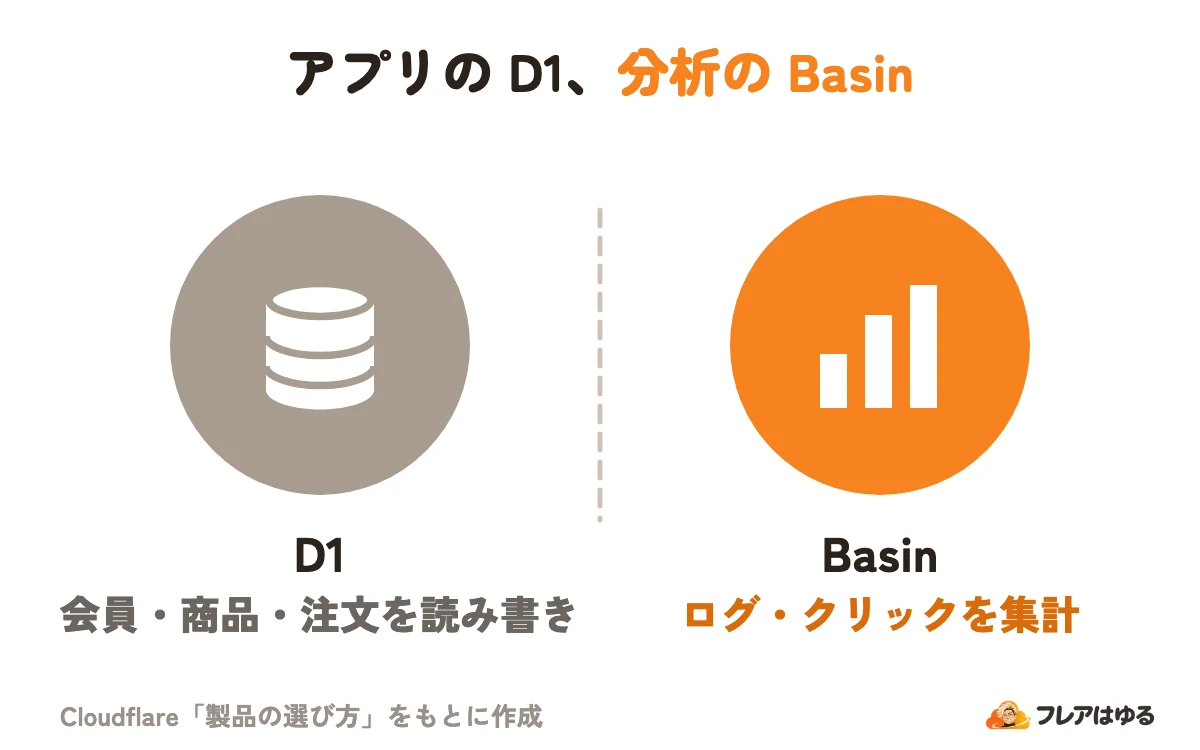
アプリが日々使うデータは D1、集計するためのログやイベントは Basin が目安です。公式の「製品の選び方」をもとに並べると次のとおりです。
K2 は、記録を最長30日(申請で延長)残し、複数の読み手がそれぞれ読む耐久性のあるログで、今はパブリックベータです。Basin は R2 の表に書いて集計するための仕組みです。Basin SQL は読み取り専用なので、アプリのデータの更新には使えません。
それぞれの仕組みは D1 の解説・Queues の解説・K2 の解説 で扱っています。
始め方:Workerのアクセスを数える
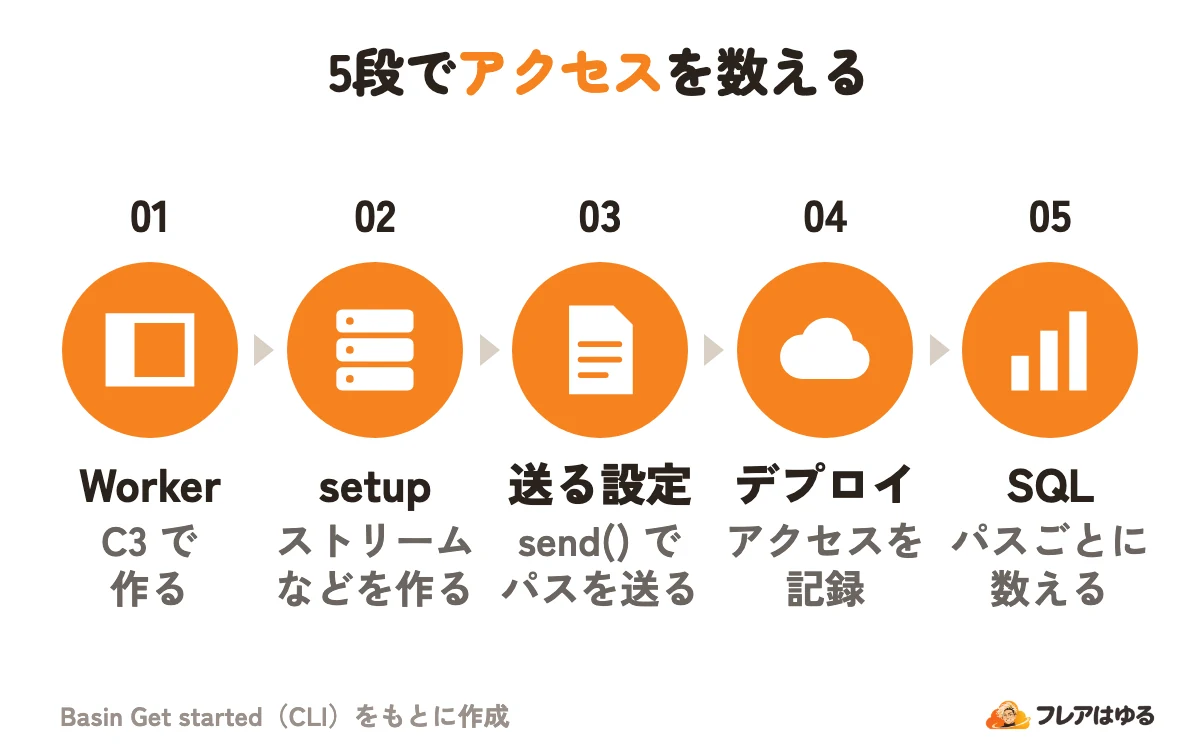
公式の Get started は、Worker へのリクエストのパスを Basin SQL で数える手順です。Workers Paid と R2 が有効なアカウント、Node.js、R2 の Account API トークン(Admin Read & Write)を用意します。
- C3 で Hello World の Worker を作る
- setup のコマンドで、ストリーム・シンク・パイプラインを作る
- 設定にバインディングを足し、コードでパスを送る
- デプロイして、
/と/exampleを開く - Basin SQL でパスごとの件数を数える
npm create cloudflare@latest -- hello-world-pipeline --type=hello-world --lang=js --no-deploy --no-git --accept-defaults
cd hello-world-pipeline
npx wrangler basin pipelines setup --name request_events手順3で足すのは、wrangler.jsonc と src/index.js の2か所です。
"pipelines": [{ "binding": "EVENTS", "stream": "<STREAM_ID>" }]await env.EVENTS.send([{ path: new URL(request.url).pathname }]);手順4・5では、公開してからウェアハウス名を調べ、トークンを環境変数に入れてクエリを送ります。
npx wrangler deploy
npx wrangler basin catalog get <YOUR_BUCKET>
export WRANGLER_BASIN_SQL_AUTH_TOKEN="<YOUR_R2_ACCOUNT_API_TOKEN>"
npx wrangler basin sql query "<WAREHOUSE_NAME>" "SELECT path, COUNT(*) AS requests FROM default.request_events GROUP BY path ORDER BY requests DESC"
バインディングに書くのは、パイプライン ID ではなくストリーム ID です。 ほかにつまずきやすいのは次の点です。
- 手順2で選ぶ項目名は、旧名の「Data Catalog (Iceberg)」
- R2 のトークンは Worker や設定ファイルに書かない
- 表が空なら、数分待ってから再実行する
使う前の注意点:あとから変えられない設定
Basin には、作ったあとに変えられない設定があります。始める前に次の点を確かめます。
- パイプラインの SQL・シンク・ストリームのスキーマは、あとから変えられない(変えるには作り直す)
- スキーマに合わないイベントは、受け付けたうえで捨てられる
- Basin SQL が読めるのは Parquet だけで、LIMIT は1万まで
- R2 にある表のファイルを直接消すと、カタログが壊れることがある
- 読むだけのツールには読み取り専用のトークンを使い、R2 側の権限もそろえる
- Basin Catalog は、既定以外の管轄(jurisdiction)の R2 バケットに対応していない
2026年11月時点の主な上限は次のとおりで、申請で引き上げを頼めます。
よくある質問
旧名で作った設定はそのまま使えますか?
使えますが、時間をかけて廃止される予定です。設定の pipeline は stream に名前が変わり、古い書き方は警告付きで動きます。2025年9月25日より前に旧 API で作ったパイプラインは legacy で、作り直しが案内されています。
Workersの無料プランで使えますか?
Basin Pipelines は Workers の有料プラン(月5ドルから)が必要です。Catalog と SQL は R2 の契約と支払いカードの登録が条件で、SQL には全プランに月10GB の無料分があります。
Basin SQLでデータを書き換えられますか?
できません。表への書き込みは Pipelines で行うか、書き込みの権限を持つ Iceberg のエンジンで行います。
Analytics Engineとは何が違いますか?
公式の選び方では、Analytics Engine は Workers から書いて SQL で読む時系列の指標向けです。ログやクリックを取り込み、表にして調べるなら Basin Pipelines が挙がっています。
送ったデータはいつから集計できますか?
すぐには表に出ません。Iceberg の表へは既定300秒、最短60秒ごとに書くためです。Logpush から送る場合も、届き始めるまで数分かかることがあります。
この記事のポイント
- Basinは取り込み・表の管理・SQLを3製品で受け持つ分析基盤
- 旧Pipelines・R2 Data Catalog・R2 SQLが今の3製品
- 料金はR2とは別。取り込みは無料で、変換・書き出し・スキャンなどで数える
- パイプラインのSQLやスキーマはあとから変えられない
まとめ
Cloudflare Basin は、取り込み・表の管理・SQL の3製品で、R2 上の Iceberg の表を扱う分析基盤です。旧名の Cloudflare Pipelines・R2 Data Catalog・R2 SQL が、今の3製品にあたります。
料金は製品ごとに数え、R2 の料金は別にかかります。まずは Get started どおりに Worker のアクセスを数えてみて、パイプラインの SQL とスキーマは本番の前に決めておきましょう。